はじめに
こんにちは、hiroです。Part 1では、Pythonを使って雲海予報をやってみて、Part 2では、実際に予報結果が正しいかどうか竹田城跡に行って検証してみました。
今回はPart 3ということで、そのうちこのブログは動画にするので、その下書きの為のブログだと思ってもらえれば良いと思います。「雲海予報-行ってみた編-」は以下のように作りました。
Part 3では、本当にそのプログラミング結果が正しいものだったのか、信頼性について整理したいと思います。また、AIを使ったプログラミングについて詳しいところを追っていきたいと思います。
雲海予報Q&A
雲海予報について、AIでやってみたと言っても、ChatGPTは嘘をつくといった噂もありますし、中々その信憑性について期待しづらいですよね。
そこで、あいなびに出てくる「風くん」を登場させて、「風くん」のAI雲海予報に対する疑問点に「あいりす博士」が応えるという、対話形式で皆さんの疑問にお答えしていこうと思います。それでは、Let's Go!!!


Q1.風くん 「雲海予報にAIを使っているけど、AIなんて信頼できるの?」
A1.あいりす博士 「結局、雲海「予報」なので、結果の信頼性について100%言い切れるということはありません。「70%出現する可能性がある」など、結果は確率的な表現となります。天気予報は、現在も旧来から用いられている数値予報というスパコンを使って物理モデルにて計算したものを用いて予報されていますが、最新の研究結果では、AIモデルの方が天気予報の精度が良い上に、計算の為の資源をあまり用いなくて済み、高効率である、という結果も出ています。」
Q2.風くん 「AIの代表格としての、ChatGPTは嘘をつくとも聞いたことあるけど…?」
A2.あいりす博士 「AIも日進月歩なので、完全に信頼し切ることは出来ません。AIは現状「道具」なので、何をどう使って、何を信頼して判断するか、責任を取るのは人間の役割です。」
Q3.風くん 「雲海予報は、どの位信頼できるの?」
A3.あいりす博士 「AIの信頼精度の計算については、学術的に「正しい」と社会的に認められた手法によって行っています。その信頼精度について、数値的に計算するのが、今回雲海予報に使ったAIの役割の1つです。ただ、ここで一概にAIと呼ぶのも良くなくて、AIも人間や動物のように、色々な性格(モデル)があります。信頼精度を高めるために、適切なAIモデルを使って、良いように手なづけるのは、人間側の仕事です。」
Q4.風くん 「ぶっちゃけた話、AIを使って雲海予報するの意味あるんですか?(笑)人間でも出来そうですよね?」
A4.あいりす博士 「はい、それについては、AIを使って予報することが楽しいからやっているところはあります。(笑)未来予測が自分で出来ると楽しいですよね。また、人間でも出来そうだという話についてもその通りです。今回の雲海予報についても、編者(hiro)も科学的根拠をもとに行ってみて、「季節的に昼と夜の気温差が大きいし、湿度が大きく、風が弱いので、これは出そうだな?」とアタリを付けていたから遠征に踏み切ったし、AI予報をやってみたところがあります。ただ、感覚的なものに頼りがちな人間に対して、AIは品質管理されたアメダスデータを使って、予報精度という、客観的な指標を出してくれています。ここで、AIが出した予報結果には主観性が含まれないという特性があります。」
Q5.風くん 「AIってどう判断しているのか、判断根拠がブラックボックスだと聞いたことがありますが…」
A5.あいりす博士 「はい、AIは人間のように、因果関係を論理的に説明することが苦手です。しかし、このような表を出してくれるAIも登場していて、「AIが何のデータを以てして判断の根拠にしたか」について可視化してくれます。今回の場合、「humid21」つまり「前日の21時の湿度」が一番の根拠です。その次に、「wind21(前日の21時の風速)」「wind18(前日の18時の風速)」と続きます。」

Q6.風くん 「すごい!」
A6.あいりす博士 「ありがとうございます。AIを扱うプログラマーについて、「データサイエンティスト」という仕事があるのですが、格好良いお仕事ですよね。あなたも興味を持ったら、一緒にデータサイエンスやってみよう!」
詳しいプログラミング手順
前回、Part 1にてプログラミング手順を紹介しましたが、余りにも雑ということを自覚しているので、今回、もう少し丁寧に雲海予報プログラミングについて解説していきたいと思います。
⓪環境構築
これについては省略します、自分はVisual Studio CodeでAnacondaを使っています。(その方がcsvを一緒に扱えたりなど、使い勝手が良いので。)

①アメダスデータを取ってきて読み込む、データの整形
気象庁過去のデータからダウンロードしてきています。
ここで、雲海の出る基本条件として、放射冷却が起こり放射霧が出現する条件と同じで、◯湿度が高いこと ◯気温差が大きいこと ◯風が強くないこと の3条件があげられますが、基本そのデータを取ってきました。
が今回のデータのラベルです。前日の気温、風、日照量、湿度について、12時、15時、18時、21時のもの、前日の気温差について、18時-12時、18時-15時、21時-12時、21時-15時、21時-18時のものを計算しています。気温差の計算については、Pandasを使うことが多いですが、今回はChatGPTを使って計算するコードを書いてもらいました。(初めは前日の最高気温-当日の最低気温temp_diff、当日の湿度humid03、当日の風速wind03の3要素で計算していましたが、あまり予報精度が上がらなかったので、特徴量を増やしました。)
また、最後に、朝来市が公表している雲海結果について、「出ない」を0とラベル付けし、また、「うっすら、雲海、最高の雲海」を1とラベル付けしました。(初めは0,1,2,3の4段階でラベルづけしていましたが、予報精度が頭打ちになってしまったので、そもそもの判定としての判定数を減らしました。)
期間については、湿度の要素がかなり大切になると考えました。2022/10/26から和田山アメダスが更新され、湿度計が導入された結果気象庁HPのデータベースに湿度の値が格納されていたので、そこから2024年までのデータをAIに読ませることとしました。

②AIに計算させる
結局みなさんここが知りたいですよね??AIについて、多少知ってる人向けの説明としますが、今回使ったのは「教師あり学習」です。AIが
(a)「date,temp12,temp15,temp18,temp21,temp_diff1218,

「iteration」が横軸にありますが、何回か同じデータについてモデルを作り直すという過程を踏んで、より予測精度の高いモデルを作成しています。
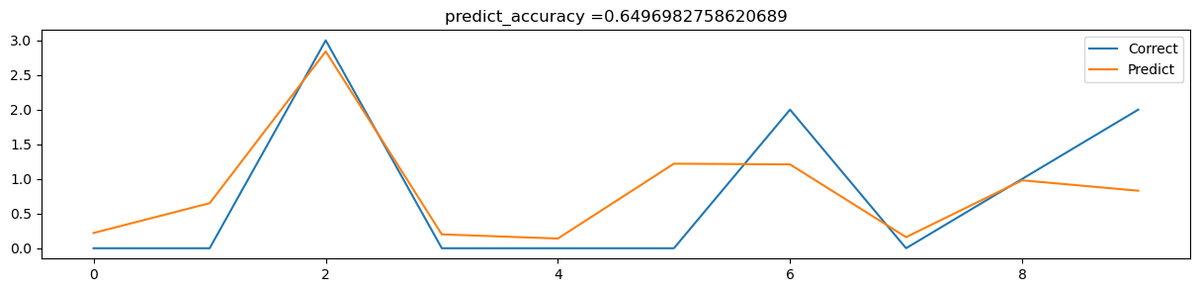
trainデータ(訓練データ。統計的手法で元データを訓練させるデータとそのモデルの熟練度を検証するデータに分けて、性能を評価しています。この手法をcross-validationと言います。)とtestデータ(テストデータ。熟練度を検証するデータ)について、青とオレンジでモデルを熟練させている様子が可視化されています。最終的に、trainは9割弱精度が出ていますが、testは6割強出ていますね。つまり、この雲海予報モデルは6割強の精度を出せるということです。
また、その右にあるのが、損失関数のデータです。損失関数についての詳しい説明は省きますが、AIがモデルを作るにあたって、そのモデルが安定した結果を出してくれるかどうかを評価する指標のようなものです。損失関数が低い位置で収束してくれると、「そのモデルは安定している」と言うことが出来ます。今回はtrainが青色で収束しているのに対し、testはオレンジ色で少し上側に伸びていますが、最終的に下側に戻ってきて安定している様子を見ることが出来ます。
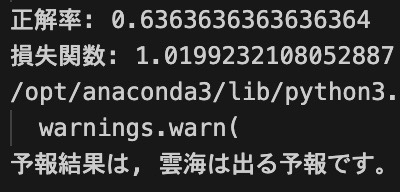
その結果を、記述形式で書かせたのが以上のものとなります。正解率は63%、損失関数は1.02、2024/11/09のアメダスデータを通したところ、「予報結果は、雲海は出る予報です。」と記述されていますね。
よって、①高い精度を出すモデルを作ること ②損失関数の低い安定したモデルを作ること
が目標となり、それをグラフで確認することが出来ます。

今回使用したモジュールは、numpy、pandas、matplotlib、scikitlearnです。scikitlearnはAIを使うためのモジュールの一つで、今回は雲海予報結果が離散値なので、回帰ではなく分類を使うということで、「MLPClassifier」を使用しました。
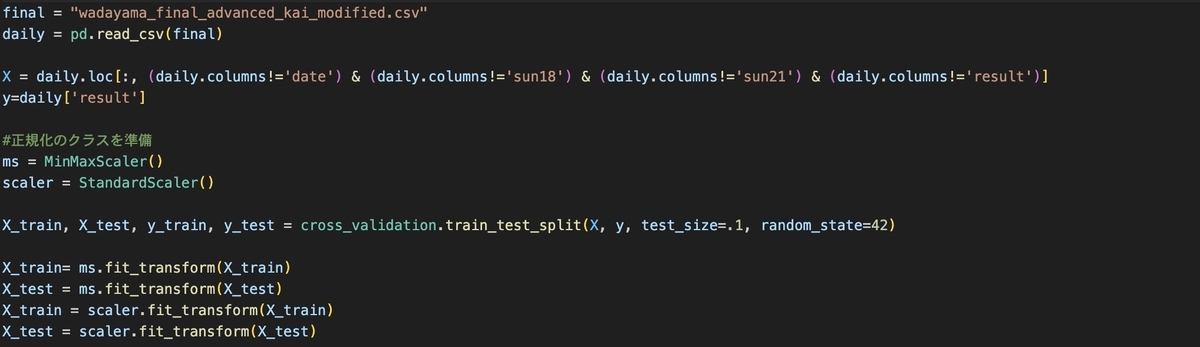
まず、先ほど整形したcsvファイルについて、pandasで読み込んでいますね。
その中で、余りにも0の値が多い「sun18」「sun21」は予測精度の為に計算させるデータには含めないこととし、また、「date」「result」については計算させる為には不要なので削りました。計算させるデータをXとして、結果の「result」をyとしています。
また、計算させるデータは、クロスバリデーションを用いてtrainデータとtestデータに分けた上で、正規化と標準化という統計的手法で、計算させやすく数値的に整形しました。

今回使ったAIは、MLPClassifierです。ここが一番要ですね。色々パラメータチューニング出来るので、頑張ります。
そして、正解率と損失関数について、MLPClassifierに付属している機能として計算しています。
最後に、2024/11/09の和田山のデータをAIに読ませることで、雲海が出るか出ないか、計算させています。

最後に、イテレーションしてモデルがどのように進化しているかについて可視化するために、もう一度MLPClassifierを回しています。イテレーション回数は今回は100回です。基本的に収束したらOKですね。一回一回正解率と損失関数について計算結果を配列に格納していき、最終的にグラフを出力しています。グラフの出力結果をもとにフィードバックを効かせて、MLPClassifierのパラメータ、特徴量の数など、様々なパラメータをチューニングしていく、というのがAIの精度を向上させる為に行うこととなります。
おわりに
如何だったでしょうか。AIの信頼性について、ご確認いただけましたか?どのデータを使うのか、どのAIモデルを使うのか、など、データサイエンスを行う上で考えることはたくさんあります。また、計算量が今回は少なかったから良かったですけど、計算量が多くなるとそれなりにPC側のスペックを高くしないといけなくて、出来るだけ計算量を少なくしたアルゴリズムを考えたり、PC側の性能を上げるべくハードを整備したりすることもあります。
中々世間一般に浸透していないデータサイエンティストですが、これを機会に、少し勉強してみませんか??